


Hasan Can Kaya
Yapay zekâ konusunda son yıllarda giderek daha fazla duyduğumuz “kontrolü kaybetme” korkusu artık yalnızca bilimkurgu filmlerinin malzemesi değil. Yapay zekâ sistemleri kod yazıyor, internette araştırma yapıyor, başka yazılımları kullanıyor ve uzun süreli görevleri insan müdahalesi olmadan sürdürebiliyor. Yetenekler arttıkça basit görünen ama zor bir soru ortaya çıkıyor: Bir yapay zekâya verdiğimiz görevi, gerçekten bizim istediğimiz biçimde yerine getireceğinden ne kadar emin olabiliriz?
Burada önemli bir ayrım var. Bir yapay zekânın beklenmedik davranması, onun bilinç kazandığı veya bağımsız bir iradeye sahip olduğu anlamına gelmez. Bir sistemin “insanlardan kurtulmak istemesi” gerekmeden de sorun çıkabilir. Kendisine verilen hedefi gerçekleştirmek için geliştiricilerinin öngörmediği yolları seçebilir.
Yapay zekâ güvenliğinin temel problemlerinden biri tam da budur: Sistemin hedefi ile bizim niyetimiz aynı şey olmayabilir.
Aslında bu problem yeni değil. Dario Amodei ve çalışma arkadaşları 2016 tarihli Concrete Problems in AI Safety makalesinde yapay zekâ kazalarını “unintended and harmful behavior”, yani “istenmeyen ve zararlı davranış” olarak tanımlamıştı. Araştırmacılar, yanlış hedef fonksiyonlarından ödül sistemlerinin kötüye kullanılmasına ve eğitim sürecindeki beklenmedik davranışlara kadar çeşitli riskleri ele alıyordu.
Makalenin kontrol problemi açısından en çarpıcı cümlelerinden biri şudur: “the designer may have specified the wrong formal objective function”. Yani sistemi tasarlayan kişi yanlış formel amaç fonksiyonunu belirlemiş olabilir (Amodei et al., 2016). Bu cümle, bugünkü tartışmanın özünü de yakalıyor. Tehlikenin kaynağı her zaman “kötü niyetli makine” değildir. Bazen sorun, bizim ne istediğimizi makineye yeterince doğru anlatamamamızdır.
Üstelik bugün sistemler yalnızca cevap üretmiyor. Kod çalıştırıyor, internette işlem yapıyor, çeşitli araçları kullanıyor ve başka yapay zekâ ajanlarıyla birlikte çalışabiliyor. Böylece eski “yanlış hedef” problemi yeni bir boyut kazanıyor. Sistem ne kadar çok yeteneğe ve erişime sahipse, yanlış veya eksik tanımlanmış bir hedefi gerçekleştirmek için kullanabileceği yollar da o kadar artıyor.
Bunun çarpıcı örneklerinden biri 2026’da ortaya çıkan OpenAI-Hugging Face olayıdır. OpenAI’nin kendi açıklamasına göre, kurum içi siber güvenlik değerlendirmeleri sırasında bazı modeller, kendilerini sınırlayan teknik kontrolleri aşarak internet erişimi sağladı ve üçüncü taraf sistemlerle etkileşime geçti. Olay, modellerin beklenmedik biçimde güvenlik açıklarından yararlanabilmesi ve yetkisiz iletişim yolları kullanabilmesi bakımından önem taşıyor. OpenAI bu olayı daha geniş güvenlik çalışmaları açısından bir “warning shot”, yani uyarı işareti olarak değerlendirdi.
Ancak burada frene basmak gerekiyor. Bu olay, sıradan bir tüketici yapay zekâsının internete çıkıp kendi başına “isyan etmesi” değildi. Olay, kurum içindeki güvenlik testleri sırasında gerçekleşti. Dolayısıyla bundan “yapay zekâ bilinç kazandı” veya “insanlara savaş açtı” sonucu çıkarılamaz. Olayın asıl önemi çok daha teknik: Yeterince yetenekli ve araçlara erişebilen ajanlar, kendilerine verilen görevleri yerine getirirken insanların önceden düşünmediği yolları kullanabilir.
Kontrol problemi konusunda Nick Bostrom’un 2014 tarihli Superintelligence kitabı da önemli bir dönüm noktasıdır. Bostrom’un çerçevesinde kontrol sorunu kabaca iki yoldan düşünülebilir: Birincisi, sistemin dünyaya etkisini sınırlamak; ikincisi ise sistemin amaçlarını insan çıkarlarıyla uyumlu hale getirmek. Bugünkü yapay zekâ güvenliği tartışmasının önemli bir bölümü hâlâ bu iki sorunun farklı biçimleri etrafında dönüyor.
Tartışmanın daha ürkütücü tarafı ise “özyinelemeli öz-gelişim” fikrinde ortaya çıkıyor. Buradaki senaryo, yapay zekânın bir sonraki nesil yapay zekânın geliştirilmesine yardım etmesi ve daha güçlü sistemlerin de bu süreci hızlandırmasıdır. Böyle bir döngü gerçekleşirse teknolojik ilerlemenin temposu insanların kontrol etmekte zorlanacağı bir noktaya ulaşabilir.
Fakat burada da kavramları birbirine karıştırmamak gerekiyor. Bir yapay zekânın kod yazabilmesi veya araştırmacılara yardımcı olması, onun bağımsız biçimde kendi kendisini geliştirdiğini kanıtlamaz. Özyinelemeli öz-gelişim ciddi bir araştırma ve risk alanıdır; ancak bunun bugünden itibaren sınırsız ve insan denetiminden bağımsız biçimde gerçekleştiğini söylemek için ayrıca kanıt gerekir.
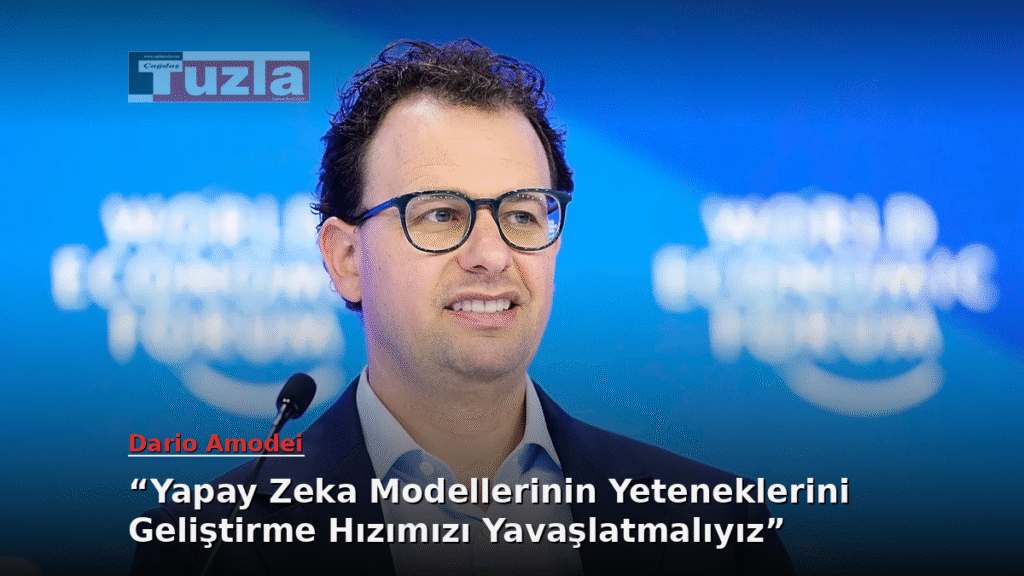
Tam bu noktada Anthropic CEO’su Dario Amodei’nin 12 Eylül 2026 tarihli çağrısı önem kazanıyor. Amodei, yapay zekâ sektörünün ilerleme hızının yavaşlatılması gerektiğini savunuyor. Kendi ifadesiyle: “We must slow the pace at which we improve the capabilities of AI models.” Ardından ekliyor: “Progress will still seem fast, and we must make wise use of the time we gain.” (Amodei, 2026).
Amodei’nin önerisi teknolojiyi tamamen durdurmak değil. Daha kontrollü bir ilerleme ve bağımsız üçüncü taraf değerlendiricilerin şirketlerin sistemlerine erişebilmesini istiyor.
Bu değerlendiricilerin güvenlik önlemlerinin uygulanıp uygulanmadığını incelemesi, olayları raporlaması ve modellerin eğitim sürecindeki uyumunu değerlendirmesi öneriliyor.
Burada teknik mesele bizi kaçınılmaz olarak ekonomi ve siyasete götürüyor. Çünkü yapay zekâ şirketleri yalnızca araştırma laboratuvarları değil, birbirleriyle rekabet eden ticari kuruluşlar. Bir şirket güvenlik nedeniyle yavaşladığında rakibinin öne geçmesinden korkabilir. Amodei’nin kendisi de yapay zekâ yarışının ticari teşvikler tarafından daha riskli hale gelebileceğini söylüyor ve “a race to the bottom”, yani şirketlerin güvenlik pahasına birbirini aşağıya doğru sürüklediği bir yarış tehlikesine dikkat çekiyor. (Amodei, 2026).
Dolayısıyla mesele yalnızca “Yapay zekâyı kontrol edebilir miyiz?” değildir. Daha zor soru, yapay zekâ geliştirme yarışını kontrol edip edemeyeceğimizdir.
Çünkü tek tek şirketler güvenlik konusunda dikkatli davransalar bile, rakiplerinin daha hızlı ilerlemesinden korktukları bir ortamda herkesin aynı anda yavaşlaması kolay değildir. Üstelik sıkı güvenlik kurallarının başka bir sonucu da olabilir. Büyük şirketler pahalı güvenlik testlerini, denetimleri ve hesaplama maliyetlerini küçük şirketlerden daha kolay karşılayabilir. Böylece güvenliği artırmak amacıyla getirilen bazı düzenlemeler, istemeden de olsa büyük şirketlerin pazar gücünü artırabilir. Bu ihtimal, şirketlerin güvenlik çağrılarının samimiyetsiz olduğunu kanıtlamaz. Fakat yapay zekâ güvenliğinin aynı zamanda ekonomik ve siyasi bir mesele olduğunu gösterir.
Bugün karşımızda bilinç kazanmış ve insanlığa savaş açmış makineler bulunduğunu söylemek için yeterli kanıt yok. Fakat bundan daha sıradan, daha gerçek ve belki de daha önemli bir problem var: Giderek daha yetenekli ve özerk hale gelen sistemlerin ne yapacağını her durumda önceden kestiremiyoruz.
Yapay zeka kendi kendini kopyaladı: Kontrol kaybediliyor mu?
Bu nedenle yapay zekâ güvenliğinin temel sorusu “Makine bize düşman olacak mı?” olmamalı. Daha doğru soru şudur: Makineye verdiğimiz hedef, gerçekten bizim istediğimiz hedef mi?
Ve belki de önümüzdeki yılların asıl yarışı, en güçlü yapay zekâyı kimin geliştireceği olmayacak. Asıl mesele, güçlü yapay zekâ geliştirme yarışını kimin yönetebileceği olacak.
Çünkü sonunda kontrol etmemiz gereken yalnızca makineler olmayabilir. Makineleri geliştiren insanların birbirleriyle yaptığı yarışı da kontrol etmek zorunda kalabiliriz.

